ICDAR 2026
结构承载语义:面向表格中心文档的细粒度语义解析
面向可靠文档理解的细粒度表格-文本语义对齐
表格承载着财务报告、风险评估与政策分析中的关键定量证据,但其真正含义往往隐藏在周围文本中。AITabler 将表格-文本关系建模为五级语义层次,结合 PDF 结构重建、版面感知上下文检索与基于 LLM 的语义推理,实现表格中心的文档解析与问答。
新南威尔士大学,澳大利亚 |
悉尼科技大学,澳大利亚 |
伍伦贡大学,澳大利亚 |
*通讯作者
摘要
表格在财务报告、风险评估和政策分析中承载关键定量证据。在这些场景中,自动化分析的可靠性依赖于表格数据与解释性文本之间准确的语义整合;一旦关联错位,就可能扭曲解释结果和下游决策。
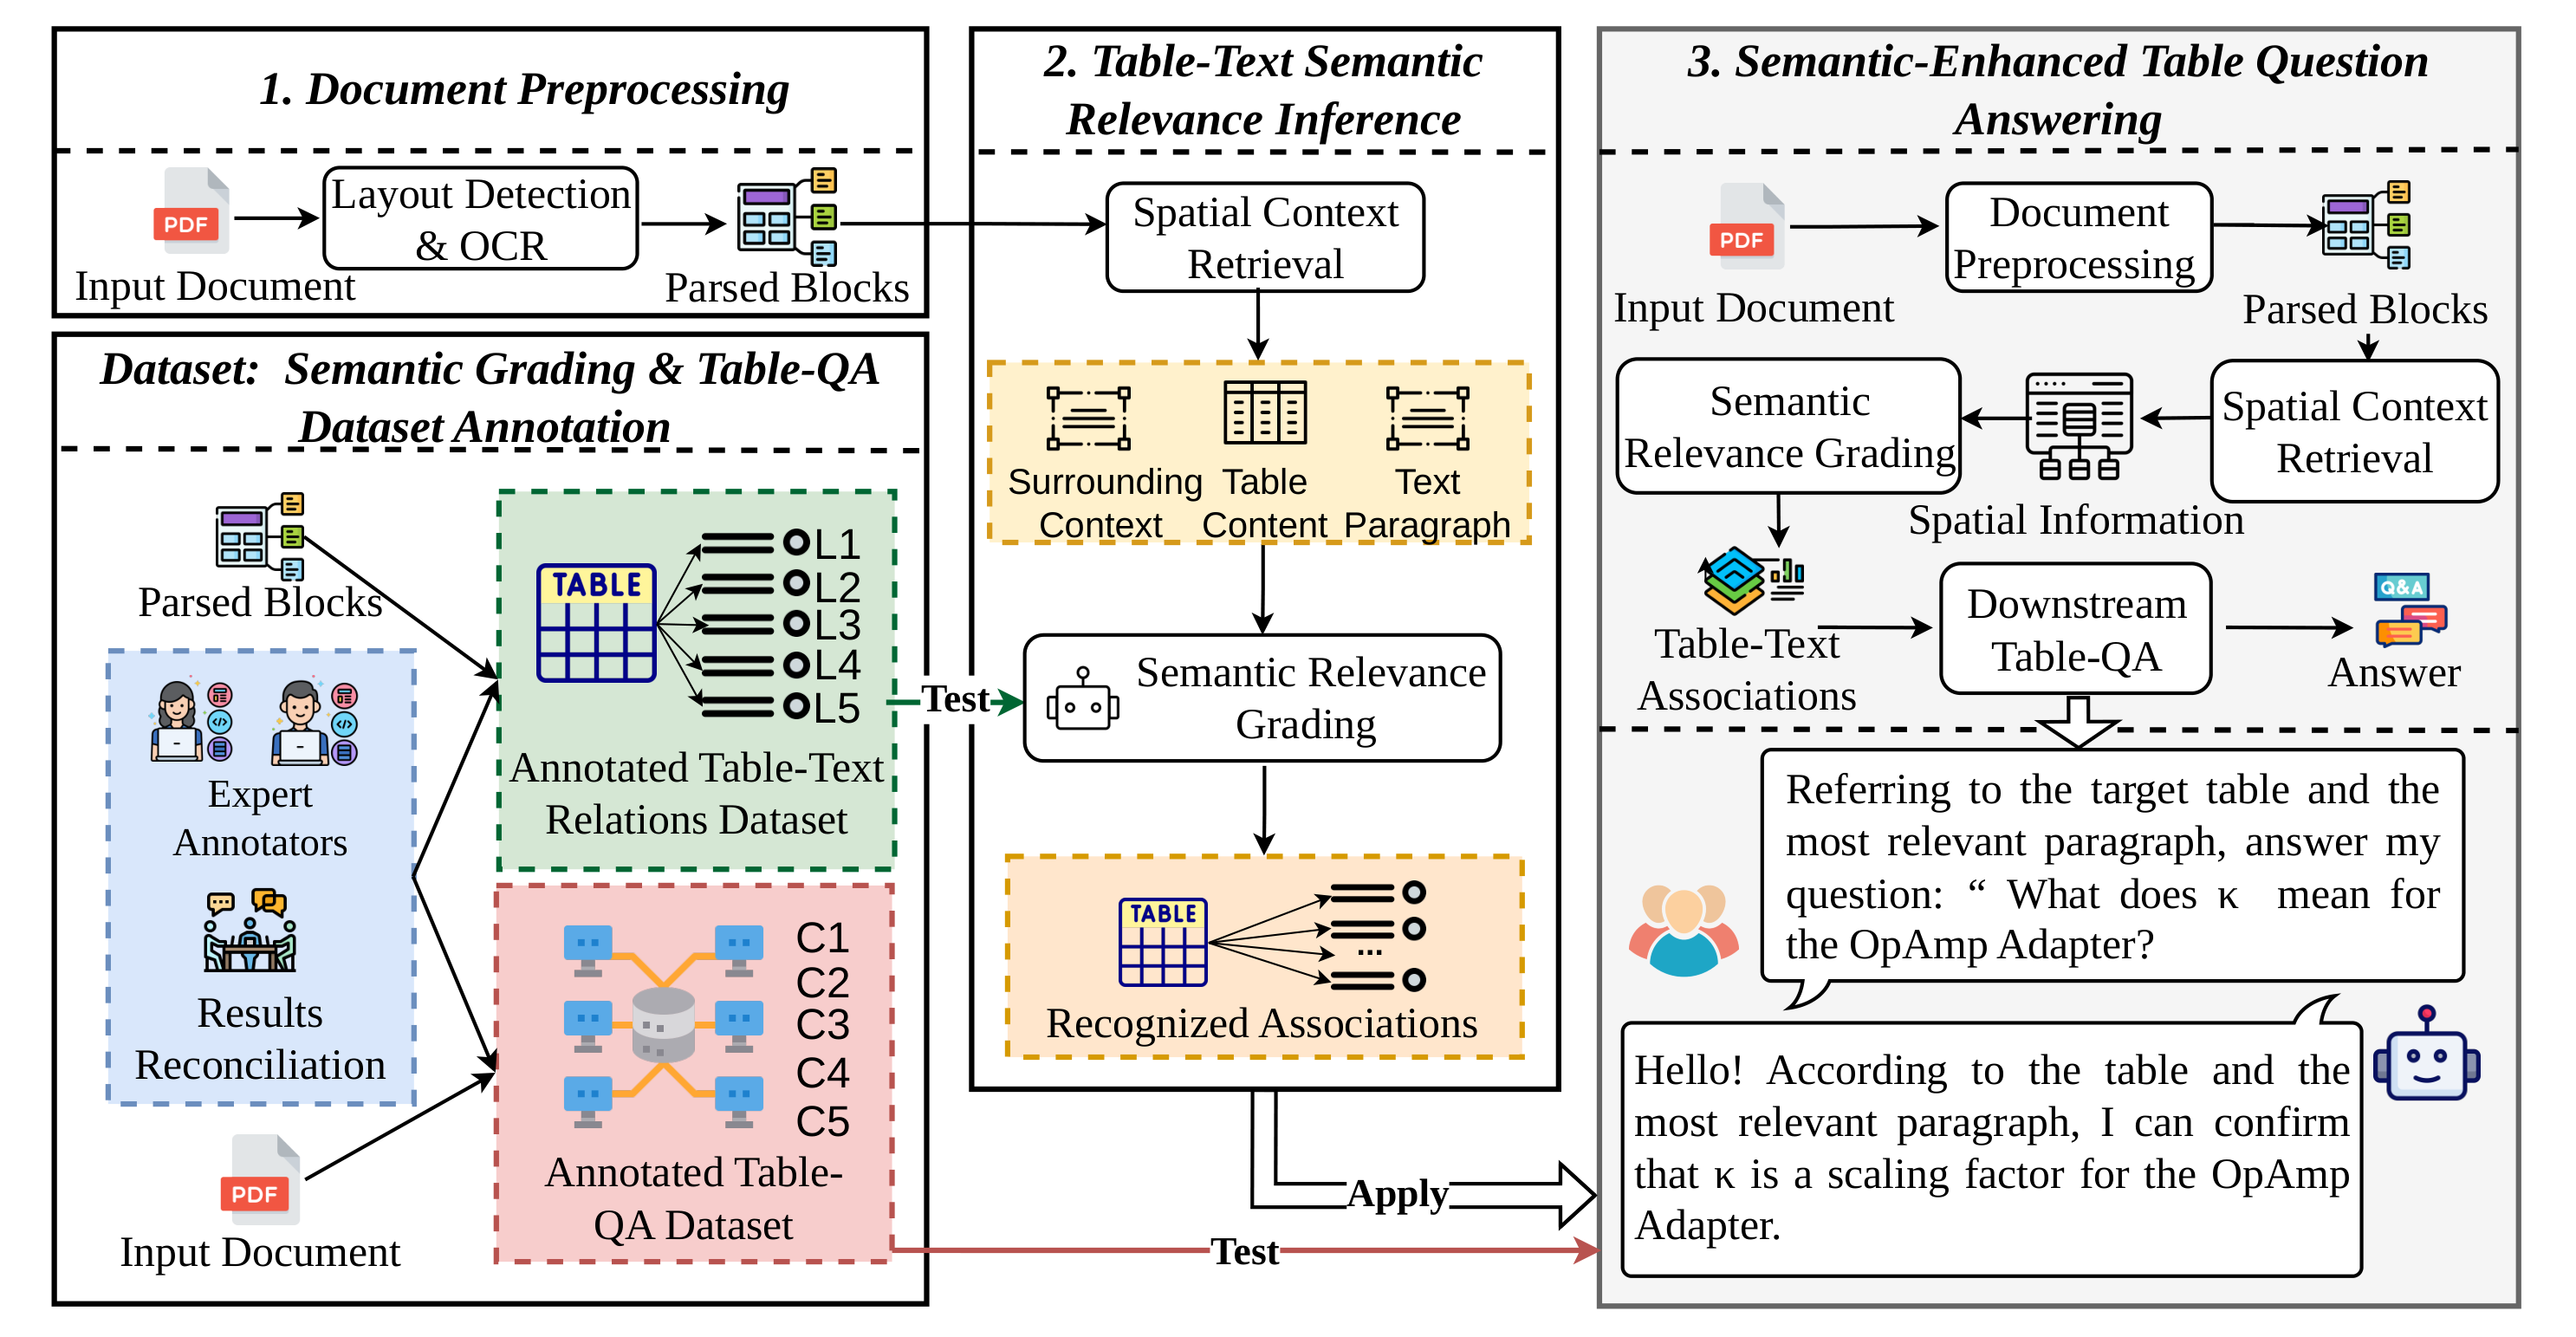
现有 PDF 表格研究主要关注视觉结构恢复,而对文档组件之间的细粒度语义对齐关注不足。为弥补这一空白,我们将表格-文本语义对齐形式化为一个五级层次框架,并提出端到端系统 AITabler,整合 PDF 结构重建、版面感知空间上下文建模与基于 LLM 的语义推理。
我们构建了两个 benchmark:包含 29,138 个标注样本对的细粒度相关性语料库,以及包含 6,000 个问题的 Table-QA 数据集,二者来自超过 3,000 页 PDF 文档。实验表明,AITabler 在相关性分级和下游 Table-QA 中均带来稳定提升。
现有 PDF 表格研究主要关注视觉结构恢复,而对文档组件之间的细粒度语义对齐关注不足。为弥补这一空白,我们将表格-文本语义对齐形式化为一个五级层次框架,并提出端到端系统 AITabler,整合 PDF 结构重建、版面感知空间上下文建模与基于 LLM 的语义推理。
我们构建了两个 benchmark:包含 29,138 个标注样本对的细粒度相关性语料库,以及包含 6,000 个问题的 Table-QA 数据集,二者来自超过 3,000 页 PDF 文档。实验表明,AITabler 在相关性分级和下游 Table-QA 中均带来稳定提升。
核心贡献
01
五级语义对齐框架
将表格-文本关系建模为层次结构,覆盖 caption reference、content alignment、topical match、contextual relevance 与 unrelated context,突破粗粒度二分类相关性。
02
端到端 AITabler 流水线
AITabler 结合 PDF 结构重建、空间上下文检索与基于 LLM 的推理,在文档级别恢复表格与文本之间的语义关联。
03
解析与问答 benchmark
构建细粒度表格-文本相关性语料库与专门设计的 Table-QA 数据集,支持可复现的表格中心文档分析研究。
方法
1. 文档结构重建
将 PDF 页面解析为版面块,使表格、标题、段落等组件能够以结构化方式表示。
2. 空间上下文检索
利用版面空间线索检索候选上下文段落,在语义分级前缩小搜索空间。
3. 五级相关性分级
通过基于 LLM 的推理,将每个表格-文本对分到五个相关性等级之一,得到比"相关/无关"更细的语义关联。
4. 语义增强 Table-QA
识别出的高价值上下文被用于下游表格问答,在避免无关段落噪声的同时提升回答准确率。
数据集与结果
29,138
标注的表格-文本样本对
6,000
Table-QA 问题
3,000+
用于构建 benchmark 的 PDF 页面
实验显示,AITabler 在强相关样本上准确率超过 98%,在弱相关样本上超过 75%,并在复杂 QA 任务上达到超过 70% 的准确率,显著优于粗粒度检索基线。
引用
@inproceedings{li2026aitabler,
  title={Meaning Lies in Structure: Fine-Grained Table-Centric Document Semantic Parsing},
  author={Li, Xuan and Xiao, Mengfei and Wei, Jingtian and Dong, Jialiang and Wong, Raymond},
  booktitle={International Conference on Document Analysis and Recognition},
  year={2026}
}