从表层到语义:面向表格中心的文档结构语义解析
现有的 PDF 解析方法停留在表层的版面分析与 OCR。DoTabler 再深一层 —— 以表格为锚点,找回与之语义关联的上下文段落,实现以表格为核心的文档解析与领域定向表格检索,并且比 GPT-4o 快两个数量级。
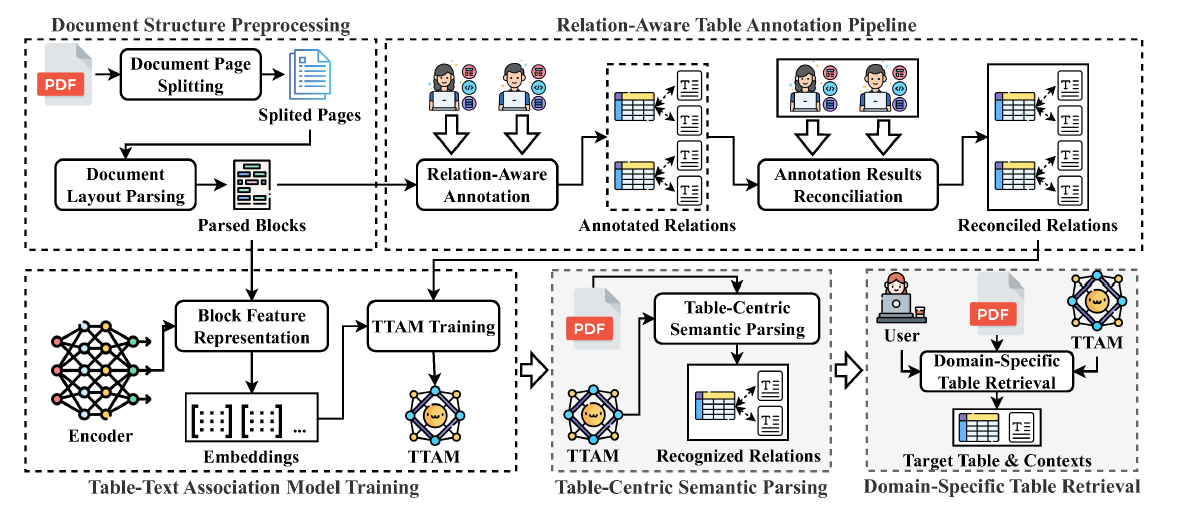
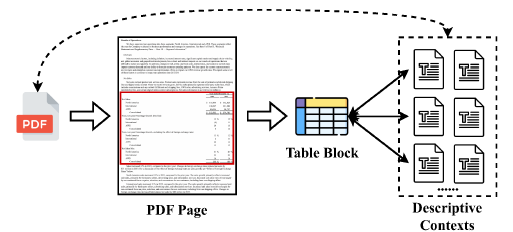
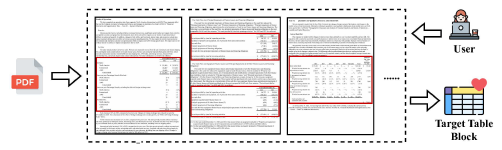
为此,我们提出 DoTabler —— 一个以表格为核心的语义级文档解析框架,致力于挖掘表格与上下文之间的深层语义关联。DoTabler 借助自建数据集与领域微调的预训练模型,串联起完整的解析流水线,识别出与每张表语义相关的上下文段落。在此基础上,DoTabler 实现两项核心能力:表格中心的文档结构解析 与 领域定向表格检索。
在来自真实 PDF、近 4,000 页、超过 1,000 张表的数据上评估,DoTabler 取得 超过 90% 的精确率与 F1,在表格–上下文语义分析任务上全面优于 GPT-4o、Gemini-2.0 与 Claude-3.5,并且速度快两个数量级。
两个应用场景
核心贡献
首个表格中心的语义级数据集
构建首个面向 PDF 表格中心结构的语义级数据集,并训练 表格–文本关联模型 TTAM,对表格与上下文的细粒度关联进行建模。
DoTabler 框架
端到端流水线整合了预处理(分页、版面、OCR)与 TTAM,在同一框架内同时实现 文档结构解析 与 领域定向表格检索。
大规模真实评估
在来自 arXiv 与 PubMed Central 的近 4,000 页、1,000+ 张表格上评估,准确率全面超过 GPT-4o、Gemini-2.0、Claude-3.5,并且快出数量级。
方法
DoTabler 把表格中心的语义解析拆成三段式流水线,每个模块都可替换 —— 可以换用更强的预训练编码器,也可以扩展到新的文档领域。
1. 文档结构预处理
每个 PDF 被渲染为图片、按页切分,送入在 PubLayNet 上微调的 Faster R-CNN 进行版面检测;Tesseract OCR 抽取 Text、List、Title、Table 块的文字。
2. 表格–文本关联模型(TTAM)
基于预训练编码器(BERT / BART / RoBERTa)的 sentence-pair 二分类器。对每对 (table, text),TTAM 输出"相关 / 无关",使用平衡的正负样本与交叉熵损失训练。
3a. 表格中心的语义解析
遍历文档中每张 Table 块,TTAM 对所有候选 Text/List 块打分,输出与该表语义相关的子集,得到一份结构化的 (table, related_paragraphs) 视图。
3b. 领域定向表格检索
用微调后的 RoBERTa cross-encoder 联合编码 (query, table),输出相关性得分,按分排序后返回 top-K 表及其上下文。训练采用 margin-based ranking loss。
数据集与实验设置
该任务此前没有公开数据集,因此我们自建了首个表格中心的语义级标注数据。文档来自 arXiv 与 PubMed Central;两位资深标注员独立标注表格–文本关联,对分歧通过专家共识机制对齐。
数据划分。TTAM 评估:3,248 个均衡的表格–文本对,按 7:3 划分为 2,273 训练 / 975 测试。检索评估:200 个查询–表格对,过滤不完整样本后得到 129 训练 / 53 测试。基线。GPT-4o、Gemini-2.0 Flash、Claude-3.5,使用相同任务提示以保证公平比较。
结果
表格–文本关联分类(TTAM)
文档级解析与检索效果
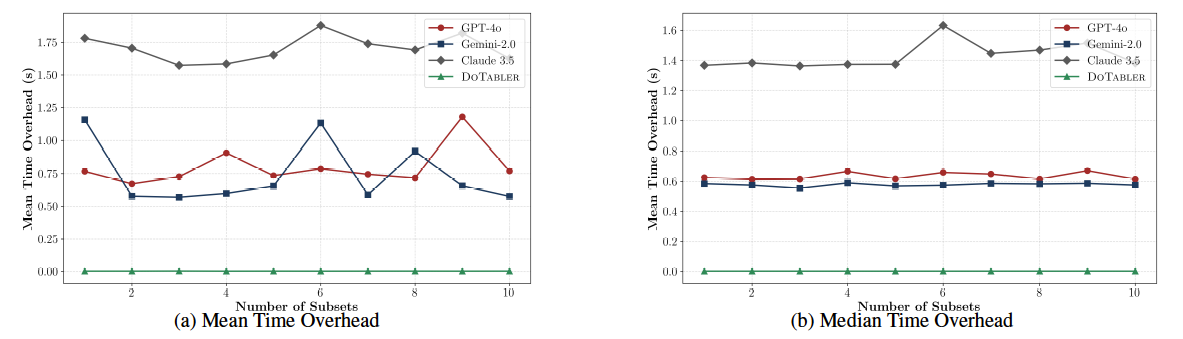
为何 DoTabler 胜出。解码器为主的 LLM 偏向流畅生成,决策上趋于保守 —— 精确率尚可但漏判很多真实关联。RoBERTa 的双向编码器在新数据集上微调后,能更好地刻画细粒度上下文依赖,对幻觉也更鲁棒,正中此任务的核心。
引用
致谢:本工作完成于新南威尔士大学。感谢两位标注员陈霄(Xiao Chen)与何况(Kuang He)在表格–文本关联数据集构建过程中的细致工作。